Modelos de IA de billones de parámetros: qué significa esa cifra
Kimi K3 declara 2,8 billones de parámetros y Qwen3.8-Max, 2,4. La palabra clave es «totales»: en estos sistemas casi nunca se enciende todo el cerebro a la vez.

Durante un par de años el relato dominante de la inteligencia artificial fue el de la miniaturización: modelos cada vez más apañados capaces de funcionar con poca memoria, poca potencia de cálculo y en aparatos modestos. Ahí las familias chinas se hicieron un hueco muy visible, con Qwen y MiniCPM como ejemplos habituales de esa carrera hacia abajo. Lo llamativo es que esa misma industria está tirando ahora con fuerza en la dirección contraria.
Las cifras dan la medida del salto. DeepSeek-V3 se presentó con 671.000 millones de parámetros totales. Moonshot AI llevó Kimi K2 hasta el billón. Y en 2026 la escalada se ha acelerado: Kimi K3 alcanza los 2,8 billones y Alibaba ha situado Qwen3.8-Max en 2,4 billones. Son números que, escritos así, no dicen gran cosa. Conviene desmontarlos.
Un número enorme que no se usa entero
Un parámetro es, simplificando mucho, uno de los diales internos que el modelo ajusta durante el entrenamiento. Cuantos más diales, más capacidad potencial de almacenar patrones del lenguaje, del código o de las imágenes. Durante años la regla fue sencilla: más parámetros, más listo el modelo, pero también más caro de entrenar y más caro de ejecutar en cada consulta.
Esa regla se rompió cuando la arquitectura dominante dejó de ser un bloque compacto. En los diseños de tipo «mezcla de expertos», el modelo se organiza en muchos subconjuntos especializados y un componente enrutador decide, para cada fragmento de texto que procesa, cuáles de esos subconjuntos entran en juego. El resto se queda apagado. Por eso la palabra totales que acompaña a las cifras no es un adorno contable: el número que se anuncia es el tamaño del armario completo, no el de la ropa que uno se pone cada mañana.
La consecuencia práctica es que un modelo puede declarar billones de parámetros y, aun así, tener un coste por consulta mucho más parecido al de un modelo bastante más pequeño. Eso explica que la escalada sea económicamente viable: se gana capacidad sin multiplicar en la misma proporción el gasto de cada respuesta.
- Parámetros totales: todo lo que el modelo guarda. Determina cuánta memoria hace falta para tenerlo cargado.
- Parámetros activos: los que realmente intervienen en cada paso. Determinan buena parte de la velocidad y del coste por consulta.
- Enrutador: la pieza que reparte el trabajo entre expertos. Si se equivoca, la calidad se resiente aunque el modelo sea gigantesco.
Las dos carreras conviven
Es tentador leer esto como un cambio de bando, como si la industria hubiera abandonado los modelos pequeños. No parece el caso: las dos direcciones responden a necesidades distintas. Un modelo compacto que cabe en un portátil o en un móvil sirve para tareas donde importan la latencia, la privacidad y el no depender de una conexión. Un modelo colosal sirve para el otro extremo: razonamientos largos, contextos enormes, tareas de programación complejas.
Lo que sí sugiere la escalada de 2026 es que el techo de lo grande no se había tocado todavía, y que quienes habían destacado optimizando hacia abajo tienen ahora la infraestructura y el conocimiento para competir también hacia arriba.
La letra pequeña
Primero, el recuento de parámetros no es una nota de examen. Comparar dos modelos por esa cifra es como comparar dos coches por la cilindrada: informa, pero no decide. La calidad de los datos de entrenamiento, el ajuste posterior y el diseño del enrutado pesan tanto o más.
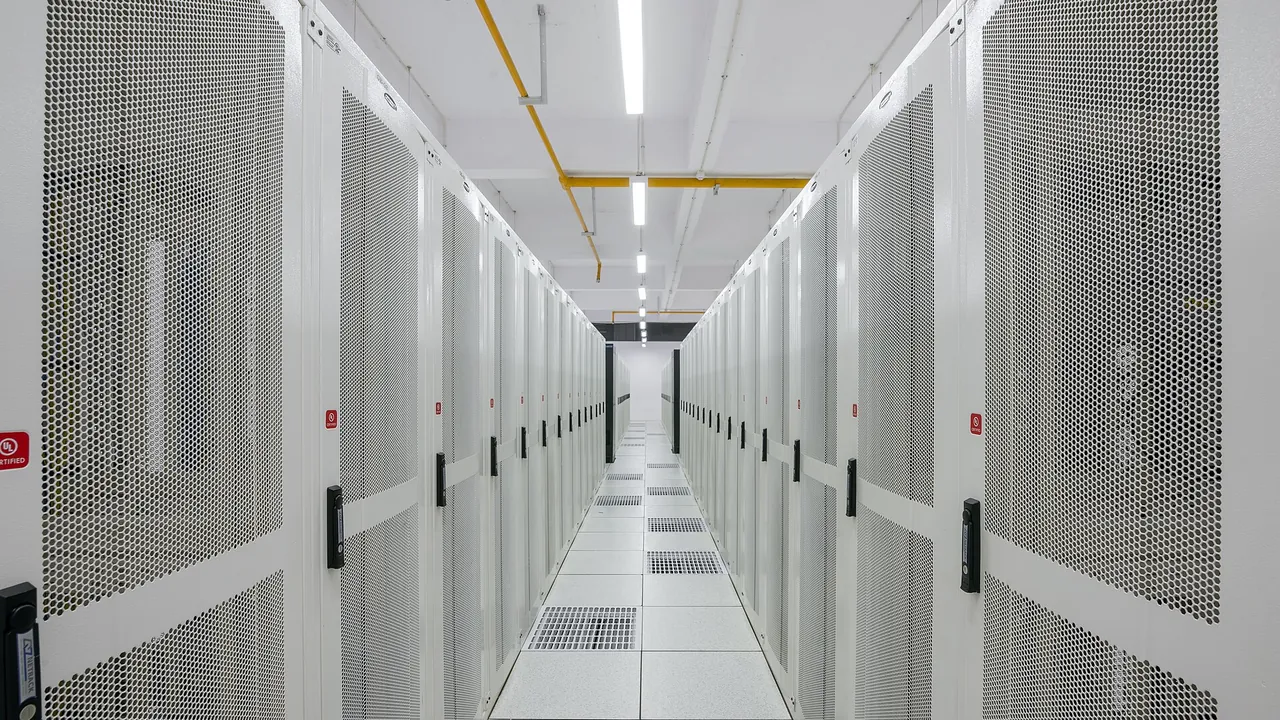
Segundo, un modelo de billones de parámetros totales sigue necesitando una cantidad brutal de memoria para estar cargado y disponible, aunque solo se encienda una fracción en cada paso. No es algo que vaya a ejecutarse en un ordenador doméstico: vive en centros de datos, y el usuario lo toca a través de una API o de una aplicación.
Tercero, «totales» frente a «activos» es exactamente el tipo de matiz que se pierde en los titulares. Cuando una cifra se anuncia sin especificar cuál de las dos es, conviene desconfiar de la comparación que venga detrás.
Por qué importa
Para quien usa estas herramientas a diario, el detalle técnico tiene una traducción muy concreta: la próxima vez que lea que un modelo tiene billones de parámetros, sabrá que ese número describe el tamaño del catálogo, no el esfuerzo de cada respuesta. Eso cambia cómo interpretar tanto las promesas de rendimiento como los precios. Y, de fondo, señala algo más interesante: la industria ya no avanza por un único eje. Hay sitio para lo diminuto que cabe en el bolsillo y para lo descomunal que vive en un armario de servidores, y durante un tiempo las dos cosas van a crecer a la vez.
Texto generado con inteligencia artificial a partir de las fuentes citadas, sin revisión humana individual (Reglamento UE 2024/1689, art. 50). Las fotos llevan su crédito y licencia; las marcadas como realzadas se han retocado con IA sin alterar su contenido.
Comentarios