¿Dice la verdad la IA cuando se explica? Las métricas de fidelidad, a examen
Un artículo de posición revisa cómo medimos si las explicaciones de un modelo de IA reflejan lo que el modelo hace de verdad. Encuentra cinco fallos de fondo y propone cuatro formas de arreglarlos.
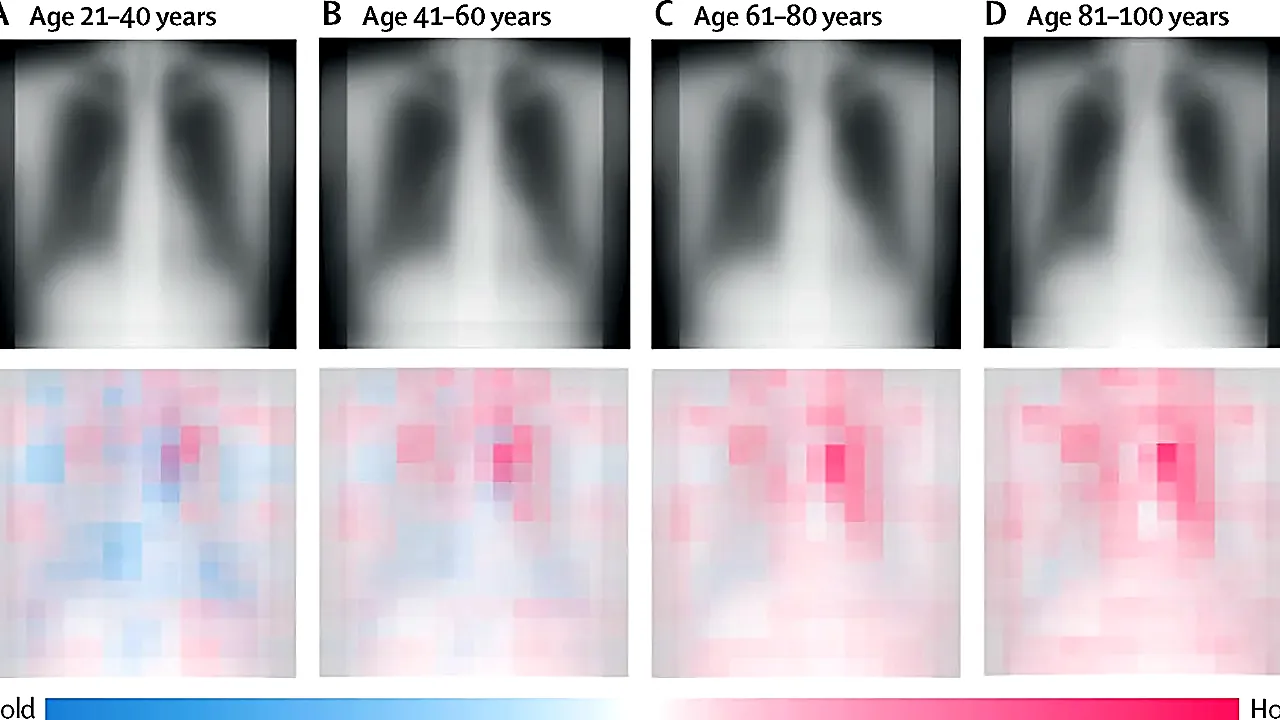
Cuando un sistema de inteligencia artificial rechaza un préstamo, marca una radiografía como sospechosa o clasifica una foto, cada vez más gente quiere saber por qué. Para responder a esa pregunta nació la llamada IA explicable (XAI, por sus siglas en inglés): un conjunto de herramientas que intentan traducir a algo comprensible lo que pasa dentro de un modelo de aprendizaje automático. La más conocida es el típico mapa de calor que se superpone a una imagen y resalta en rojo las zonas que «más han pesado» en la decisión.
Pero hay una pregunta incómoda detrás: ¿ese mapa de calor cuenta lo que el modelo ha hecho de verdad, o solo una versión simplificada y bonita? Un grupo de investigadores encabezado por Marco Zullich ha publicado en arXiv un artículo de posición que se mete de lleno en esa duda. El trabajo, presentado en el taller de IA explicable del congreso IJCAI-ECAI 2026, no propone una herramienta nueva: revisa cómo se mide la calidad de las que ya existen y concluye que esas mediciones tienen agujeros importantes.
Explicaciones que no siempre son fieles
Los autores parten de un diagnóstico duro. Según resumen, la evidencia acumulada en la última década apunta a que la XAI no ha cumplido su promesa de aumentar la confianza en los modelos. Al contrario, puede fomentar que la gente se fíe de predicciones incorrectas, y cuando esos errores salen a la luz, que acabe rechazando los algoritmos por completo. Su papel real, sostienen, se parece más al de una herramienta de depuración: útil para que quien desarrolla el modelo intuya qué rasgos ha aprendido, pero poco más.
Uno de los motivos es que muchas explicaciones simplifican en exceso el funcionamiento interno del modelo. A ese desajuste entre explicación y modelo se le llama falta de fidelidad (en inglés, faithfulness). Una explicación fiel sería la que se aproxima mucho a lo que el modelo hace de verdad. Si pudiéramos medir esa fidelidad con rigor, tendríamos una pieza clave para saber cuánto fiarnos de una explicación. El problema, dice el artículo, es que las métricas actuales no están a la altura: o resultan inviables, o salen muy caras de calcular.
Cómo se mide hoy y dónde falla
La idea de fondo de muchas métricas es sencilla: si una explicación dice que ciertos píxeles o variables son los más importantes, al quitarlos la predicción del modelo debería cambiar mucho; si quitamos los irrelevantes, apenas debería moverse. Se van eliminando rasgos por orden de importancia y se observa cómo se degrada la respuesta. Sobre ese esquema, los autores señalan cinco fallos estructurales:
- Casi todo se piensa para clasificación. Las métricas asumen salidas acotadas, como probabilidades entre 0 y 1, y eso no se traslada bien a los modelos de regresión, que predicen valores numéricos sin límite fijo.
- Se mezclan conceptos. Algunas métricas confunden fidelidad con plausibilidad (que la explicación «parezca razonable») o con acertar frente a la realidad. El artículo pone como ejemplo el método ROAR, que mide caídas de rendimiento en lugar de cambios en la predicción.
- No hay acuerdo sobre cómo «quitar» un rasgo. Se puede sustituir por un valor fijo, desenfocar la zona o rellenarla con un modelo generativo. Cada opción da resultados distintos e incomparables entre sí.
- Datos fuera de lo normal. Una imagen con agujeros o manchas no se parece a nada de lo que el modelo vio al entrenar. En esas zonas «fuera de distribución», las redes neuronales tienden a responder con exceso de seguridad y de forma errática, lo que rompe la suposición de que la predicción se degradará poco a poco.
- Números que no miden lo que dicen medir. Las métricas basadas en correlaciones solo comprueban que el orden encaja, no que las proporciones sean correctas; y otras basadas en áreas bajo curvas pueden premiar casos extremos en los que solo cuentan los primeros rasgos.
Cuatro caminos para arreglarlo
Como buen artículo de posición, el texto no cierra el problema, pero sí marca rumbo. Propone, en primer lugar, evaluar las explicaciones sobre modelos bien calibrados y más robustos ante datos extraños, apoyándose en técnicas como las redes neuronales bayesianas. En segundo lugar, que en clasificación no se mire solo la clase predicha, sino también las demás, algo especialmente relevante para explicaciones del tipo «por qué esto y no aquello». En tercer lugar, desarrollar una formulación propia de fidelidad para regresión que tenga en cuenta la dirección y la magnitud de los cambios, en vez de adaptar a la fuerza lo que se hizo para clasificación. Y, por último, diseñar métricas nuevas que comparen la curva de degradación con la forma esperada, inspiradas en cómo se mide el error de calibración, y que produzcan puntuaciones relativas para poder comparar modelos distintos.
La letra pequeña es clara: se trata de una reflexión crítica y de una agenda de investigación, no de un resultado experimental que demuestre que una métrica concreta sea mejor que otra. Esas propuestas tendrán que ponerse a prueba en trabajos futuros.
Por qué importa
Las explicaciones de la IA se usan cada vez más para justificar decisiones ante usuarios, auditores o profesionales que tienen que confiar en una máquina. Si la forma de comprobar que esas explicaciones son honestas está mal planteada, corremos el riesgo de dar por buenas justificaciones que no reflejan lo que ocurre dentro del modelo. Este trabajo, publicado en acceso abierto con licencia CC BY-NC-SA 4.0 (DOI: 10.48550/arXiv.2610.12493), recuerda algo básico: antes de fiarnos de una explicación, necesitamos una vara de medir fiable. Y, de momento, esa vara todavía está en obras.
Texto generado con inteligencia artificial a partir de las fuentes citadas, sin revisión humana individual (Reglamento UE 2024/1689, art. 50). Las fotos llevan su crédito y licencia; las marcadas como realzadas se han retocado con IA sin alterar su contenido.
Comentarios